NTDH——将情感分析重构为可验证的复杂推理
本文记录我学习 NTDH(Naturalisation · Tolerance-aware Verification · Domain-aware Refinement · Directional Hints) 的过程。
这篇工作的核心并不是提出一个新的强化学习算法,而是回答一个更基础的问题:
如果希望用 SFT + GRPO 训练“会推理”的情感分析模型,
什么样的 reasoning 数据才值得拿来训练?
作者给出的答案可以概括为:
原始情感标签↓把 gold label 统一成自然语言目标↓让 teacher 生成 reasoning↓用任务真实标准验证 reasoning 的结论↓失败时进行领域化修正,但不泄漏 gold↓得到 verified reasoning traces↓SFT 学习推理格式和模式↓GRPO 用可验证奖励继续优化这份笔记主要想弄清楚几个问题:
- 为什么情感分析不仅是“文本 → 标签”的分类问题?
- 回归、序数分类、多标签分类如何统一成同一种生成式接口?
- N、T、D、H 四个组件分别解决什么数据质量问题?
- Naturalisation 为什么不只是“把数字改写成一句话”?
- 为什么 deterministic verifier 比通用 LLM Judge 更合适?
- Directional Hint 如何避免 label leakage?
- Half-A、Half-B、SFT 数据和 RL 数据到底如何流转?
- SFT 和 GRPO 在整个系统中分别承担什么职责?
- 实验真正证明了什么,哪些地方又不能夸大?
- 为什么作者强调“数据质量 > 数据数量”?
- 这篇论文最值得继续改进的方向是什么?
---
1. 这篇论文到底在做什么
Section titled “1. 这篇论文到底在做什么”传统情感分析通常把任务写成:
Text↓Encoder / LLM↓Prediction Head / Final Answer↓Label这种方式的问题不是“不能做情感分类”,而是:
模型为什么得到这个判断?中间 reasoning 是否可信?reasoning 能否被自动检查?错误 reasoning 能否继续用于强化学习?NTDH 把任务重新写成:
Text↓Affective Reasoning↓Task-specific Answer↓Verifier↓SFT / GRPO统一输出格式为:
<think>结构化的情感推理过程</think>
<answer>任务对应的最终答案</answer>
所以,这篇论文真正的重点可以用一句话概括:
先构造可信、可验证、无标签泄漏的 reasoning 数据,再用 SFT + GRPO 训练统一的情感推理模型。
它的创新重点不是“发明 GRPO”,而是围绕 reasoning data recipe 做设计。
---
2. 为什么情感分析需要统一成“推理任务”
Section titled “2. 为什么情感分析需要统一成“推理任务””SemEval-2018 Task 1 中包含四种形式完全不同的任务。
| 子任务 | 含义 | 输出空间 | 示例 |
|---|---|---|---|
| EI-reg | Emotion Intensity Regression | 0 ~ 1 | anger = 0.562 |
| V-reg | Valence Regression | -1 ~ 1 | valence = 0.532 |
| V-oc | Valence Ordinal Classification | -3 ~ 3 | class = +2 |
| E-c | Emotion Classification | 11 类多标签集合 | {anticipation, optimism} |
传统做法一般意味着:
EI-reg → 回归 head + 回归 loss
V-reg → 另一套回归目标
V-oc → 7 类序数分类
E-c → 11 类多标签分类
这些任务虽然都叫“情感分析”,但 label space 并不相同。
NTDH 的处理方式是:
所有任务↓统一写成条件生成↓共享 affective cue reasoning↓最后的 answer 保持任务特定↓每个任务使用自己的 verifier这样做之后,统一的是:
reasoning interface而不是强行统一:
label space这是理解整篇论文非常重要的一点。
---
3. 为什么情感判断不是“看关键词打标签”
Section titled “3. 为什么情感判断不是“看关键词打标签””情感表达常常存在相互冲突的线索,例如:
否定:not happy
强度:slightly / very / extremely
反讽:字面正面,但真实态度负面
习语与隐喻:不能简单做词义相加
多情绪共存:anger + disgustjoy + optimism
正负子句冲突:需要判断哪一条 cue 更重要
例如:
Oh great, another Monday. Just what I needed.如果只看:
greatneeded很容易得到正面判断。
但结合上下文后:
"Oh great"+"another Monday"+"Just what I needed"↓sarcasm↓真实 valence 偏负面因此作者把可靠的 affective analysis 理解为:
表层词义↓上下文↓否定 / 强度 / 反讽 / 习语↓多情绪与冲突线索↓最终判断这也是为什么论文认为它更接近一个 complex reasoning problem,而不是平坦分类。
---
4. Affect × Reasoning 的研究空白
Section titled “4. Affect × Reasoning 的研究空白”在这篇论文之前,两条研究路线相对分开。
4.1 Affective Analysis
Section titled “4.1 Affective Analysis”典型工作包括:
BERTRoBERTaBERTweetSentiBERTEmoLLMTHORDECC其中很多工作已经能做统一 instruction tuning,或者在推理阶段加入 CoT。
4.2 Complex Reasoning
Section titled “4.2 Complex Reasoning”另一条路线则更关注:
Reasoning trace synthesis↓Verifier↓SFT↓RL这类方案在数学、医学等“答案比较容易程序化检查”的领域更成熟。
4.3 直接把通用 reasoning pipeline 搬到情感任务会出现什么问题
Section titled “4.3 直接把通用 reasoning pipeline 搬到情感任务会出现什么问题”论文总结了四类核心问题:
| 问题 | 直接后果 | NTDH 对应组件 |
|---|---|---|
| 目标表示不稳定 | teacher 最终数值/标签可能漂移 | N |
| 验证器不匹配 | LLM Judge 不知道真实容差与评分标准 | T |
| refinement 太通用 | think again 不懂情感领域 cue | D |
| fallback 泄漏标签 | 把 gold 塞回 prompt,CoT 变成事后合理化 | H |
所以 NTDH 不是四个随意拼接的模块,而是四个具体失败模式对应的修复件。
---
5. NTDH 四个组件是什么
Section titled “5. NTDH 四个组件是什么”NTDH 分别代表:
N = Naturalisation
T = Tolerance-aware Verification
D = Domain-aware Refinement
H = Directional Hints
可以先做一个总体理解:
| 组件 | 解决的问题 | 核心作用 |
|---|---|---|
| N | SFT target 可能来自 teacher 漂移答案 | 最终监督答案始终来自 gold |
| T | LLM Judge 与 benchmark 标准不一致 | 使用任务特定 deterministic verifier |
| D | 通用 rethink 缺乏情感知识 | 用 affective cue 指导 refinement |
| H | 失败后直接告诉 gold 会泄漏标签 | 只告诉错误方向,不告诉正确答案 |
整体逻辑是:
N:保证“答案源头正确”T:保证“验证标准正确”D:保证“怎么重想更专业”H:保证“提示模型但不泄题”---
6. 总体流程:Reasoning-path Synthesis → SFT → GRPO
Section titled “6. 总体流程:Reasoning-path Synthesis → SFT → GRPO”整套流程如下图所示:
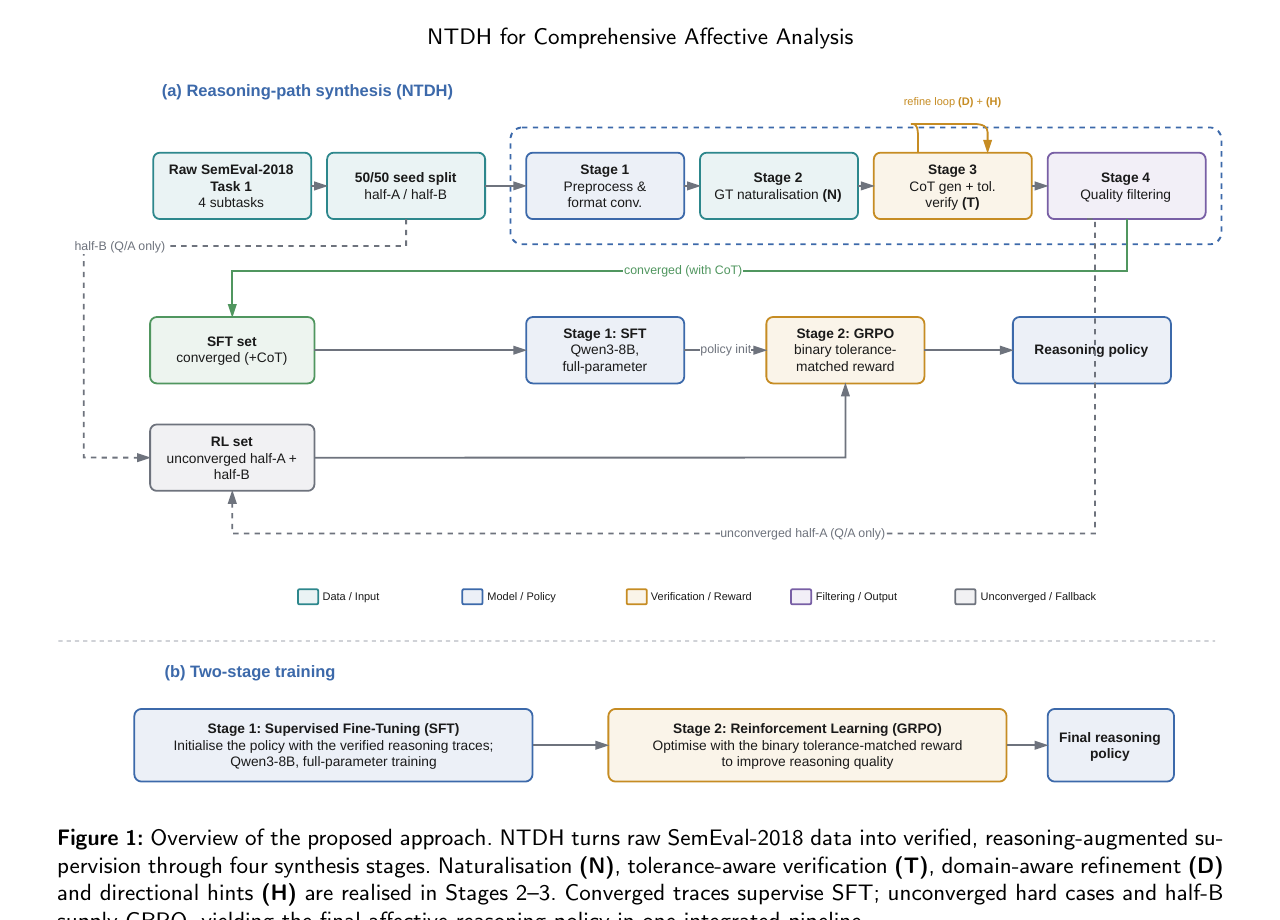
整个 pipeline 最值得记住的是五条线:
1. 原始数据先做 50 / 50 split
2. Half-A 用于 reasoning synthesis
3. Half-A 中成功收敛的 reasoning → SFT
4. Half-A 的 hard cases 不丢弃,而是转入 RL
5. Half-B 不生成 CoT,直接作为 Q/A-only RL 数据
最终:
SFT↓得到一个“已经会基本 reasoning”的 policy↓GRPO↓用严格、可验证 reward 继续优化---
7. N:Naturalisation——保证 SFT 的最终答案来自 Gold
Section titled “7. N:Naturalisation——保证 SFT 的最终答案来自 Gold”Naturalisation 表面上看只是把 raw label 改写成自然语言。
例如:
Raw:0.562
Naturalised:The anger emotion has an intensity of 0.562on a scale from 0 to 1.
但它真正解决的问题不是“文本更自然”,而是:
SFT 的
<answer>到底应该来自 teacher,还是来自 gold?
假设:
Gold y = 0.55
Teacher candidate ŷ = 0.53
因为:
|ŷ - y| = 0.02 ≤ 0.05这条 reasoning 可以通过 verifier。
但是最终写入监督数据时,NTDH 不会保留:
<answer>0.53</answer>而是改成:
<answer>0.55</answer>也就是:
Teacher candidate↓只负责验证 reasoning 是否大致正确
Gold label↓负责真正的 supervised target
这一点非常关键。
论文的统计显示,在 Half-A 的 8,150 条初始生成中,只有约:
18.4%的 teacher 初始结论落在 gold tolerance 内。
因此如果直接把 teacher 自己的结论当 SFT target,会把大量漂移答案固化进监督数据。
Naturalisation 的核心价值可以总结为:
保留 teacher 的 reasoning,但不信任 teacher 的最终监督标签。
需要注意,论文中强调的“100%”指的是:
所有 retained SFT answer 都来自 gold不是:
模型预测准确率 = 100%---
8. T:Tolerance-aware Verification——验证标准必须和任务标准一致
Section titled “8. T:Tolerance-aware Verification——验证标准必须和任务标准一致”通用 LLM Judge 常见的做法是:
Candidate Answer + Reference Answer↓LLM Judge↓True / False问题在于,情感任务的“正确”是有严格定义的。
例如:
Gold = 0.56
Candidate A = 0.55Candidate B = 0.70
如果 judge prompt 没有明确容差,那么它可能:
误拒绝 0.55误接受 0.70这会导致:
Reasoning data 的验证标准≠Benchmark 的真实评分标准NTDH 因此使用任务特定 verifier。
8.1 EI-reg / V-reg
Section titled “8.1 EI-reg / V-reg”构造阶段与 GRPO 都使用:
|ŷ - y| ≤ 0.058.2 V-oc
Section titled “8.2 V-oc”使用:
exact class match8.3 E-c
Section titled “8.3 E-c”构造 reasoning 时使用:
label-set F1 ≥ 0.7GRPO 时则更严格:
exact label-set match所以四类任务的验证方式可以整理为:
| 任务 | Reasoning 构造阶段 | GRPO strict criterion |
|---|---|---|
| EI-reg | ` | ŷ-y |
| V-reg | ` | ŷ-y |
| V-oc | exact class | exact class |
| E-c | label-set F1 ≥ 0.7 | exact label-set |
消融中,换回 LLM Judge 后,对“超容差错误”的错误接受率达到:
EI-reg:62.7%V-reg:47.5%而 deterministic verifier 为:
0%因此 T 的意义不是“judge 更聪明”,而是:
当答案可以程序化验证时,尽量不要让另一个 LLM 去猜什么叫正确。
---
9. D:Domain-aware Refinement——“重新想”也要有领域知识
Section titled “9. D:Domain-aware Refinement——“重新想”也要有领域知识”当初始 reasoning 失败时,最简单的 refinement prompt 是:
Think again.问题是这种反馈几乎没有告诉模型:
应该检查什么?应该从哪个角度重新分析?NTDH 加入 affective science 相关的领域 cue。
9.1 Backtracking
Section titled “9.1 Backtracking”重新检查先前 reasoning 是否忽略了更深层线索:
negationintensifierdiminisherirony9.2 Explore New Paths
Section titled “9.2 Explore New Paths”换一种解释路径:
idiommetaphorPlutchik emotion co-occurrenceRussell circumplex9.3 Verification
Section titled “9.3 Verification”重新对照文本中的:
emotion wordsshiftersemojipunctuation9.4 Correction
Section titled “9.4 Correction”对局部判断做细粒度修正:
slightly < very < extremely
anger ↔ disgust
contextual polarity
需要注意,D 的总体实验收益并没有特别夸张。
论文报告:
总体 convergence:65% → 66%几乎没有明显变化。
但在 E-c 上:
46% → 56%大约提升 10pt。
因此更准确的理解是:
D 主要给 reasoning 注入情感领域的归纳偏置,对多标签情绪任务尤其有帮助,但它不是一个全面提高收敛率的万能组件。
---
10. H:Directional Hints——告诉模型“错在哪”,但不告诉答案
Section titled “10. H:Directional Hints——告诉模型“错在哪”,但不告诉答案”reasoning synthesis 中最危险的一种 fallback 是:
Gold answer = -0.5.Please rethink.这样做很容易让模型“修正成功”。
但得到的 reasoning 可能只是:
先看到答案↓再倒推出一个看起来合理的解释这会造成:
label leakage并污染 SFT 数据。
NTDH 的做法是只提供方向性提示。
例如:
Gold = -0.5Prediction = +0.6不告诉模型:
正确答案是 -0.5而只告诉:
The sentiment may be too positive given the context.也就是:
知道“方向错了”但不知道“正确值是多少”不同任务的提示形式也不同。
10.1 EI-reg / V-reg
Section titled “10.1 EI-reg / V-reg”too highslightly highcloseslightly lowtoo lowvalence 中也可以写成:
too positivetoo negative10.2 E-c
Section titled “10.2 E-c”over-identifiedincompletepartially correct10.3 V-oc
Section titled “10.3 V-oc”根据差几个等级给出:
slightly too positive / negativetoo positive / negativefar too positive / negative论文最终的 Quality Tier 中:
Low tier = 空也就是说,作者没有靠“把 gold 直接注入 prompt”强行救活样本。
救不回来的样本直接进入 RL。
---
11. 单条样本是怎么生成 reasoning 的
Section titled “11. 单条样本是怎么生成 reasoning 的”Stage 3 的内循环如下图所示:
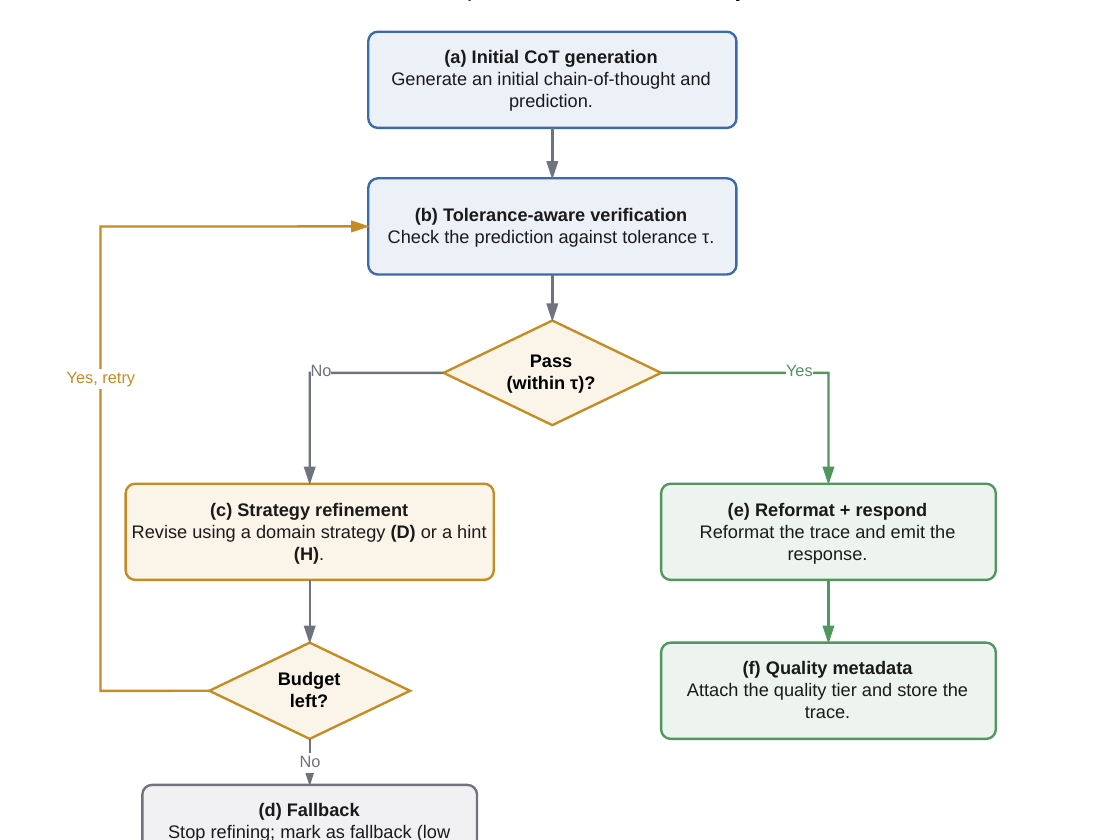
论文中的搜索预算为:
Fresh restart A = 3
每次 refinement depth D = 3
最重要的是区分:
candidate ŷ和:
supervised answer y两者的职责完全不同。
candidate ŷ:验证 reasoning 是否达到要求
gold y:真正进入 SFT 的 answer target
---
12. 一个反讽样本如何被修正
Section titled “12. 一个反讽样本如何被修正”论文中的典型示例是:
Oh great, another Monday. Just what I needed.Gold:
valence y = -0.5Step 1:初始 reasoning
Section titled “Step 1:初始 reasoning”模型只看到字面:
greatneeded于是预测:
ŷ = +0.6Step 2:Tolerance-aware Verification
Section titled “Step 2:Tolerance-aware Verification”|0.6 - (-0.5)| = 1.1显然:
1.1 > 0.05所以 reject。
Step 3:Directional Hint
Section titled “Step 3:Directional Hint”系统不会说:
正确答案是 -0.5只会反馈:
too positiveStep 4:Domain-aware Refinement
Section titled “Step 4:Domain-aware Refinement”Backtracking 后发现:
Oh great...another MondayJust what I needed在上下文中构成 sarcasm。
Step 5:重新预测
Section titled “Step 5:重新预测”模型把 valence 修正为负面,并重新通过 verifier。
最终:
reasoning → 保留
answer → 使用 naturalised gold
这条样本才会进入 SFT。
---
13. Half-A / Half-B、SFT / RL 数据如何分流
Section titled “13. Half-A / Half-B、SFT / RL 数据如何分流”总训练实例:
16,302先做 50 / 50 split:
| 数据 | 数量 | 用途 |
|---|---|---|
| Half-A | 8,150 | 做 CoT synthesis |
| Half-B | 8,152 | 不生成 CoT,直接进入 RL |
Half-A 最终得到:
5,404 converged traces其中有:
16 条 empty / invalid chain所以真正进入 SFT 的数据为:
5,388Half-A 中剩余 hard cases:
2,746 unconverged+16 empty / invalid=2,762它们不会被丢弃,而是转入 RL。
因此最终 RL 数据:
Half-B 8,152+Half-A hard cases 2,762=10,914数据流可以总结为:
16,302 total├── Half-A 8,150│   ├── SFT 5,388│   └── RL hard cases 2,762│└── Half-B 8,152    └── RL 8,152
Final:SFT = 5,388RL  = 10,914
论文强调:
每个训练实例只使用一次---
14. Quality Tier 是什么
Section titled “14. Quality Tier 是什么”根据一条 reasoning 第几次验证成功,论文把数据划成:
| Tier | 条件 | 建议权重 |
|---|---|---|
| Gold | 第 1 次成功 | 1.0 |
| Silver | 第 2–3 次成功 | 0.8 |
| Bronze | 第 4 次及以后成功 | 0.5 |
| Low | 依赖 label leakage 才成功 | 0.0 |
| Unconverged | 最终仍未成功 | 0.0 |
但有一个很容易误读的地方:
论文当前并没有真的按 Gold / Silver / Bronze 权重训练 SFT。
实际训练中:
所有 retained SFT traces↓统一权重Quality-weighted SFT 只是未来工作。
---
15. 第一阶段:SFT 做了什么
Section titled “15. 第一阶段:SFT 做了什么”SFT 使用:
5,388 条verified + non-empty reasoning trajectories基座模型:
Qwen3-8B而且不是 LoRA,而是:
full-parameter SFT目标格式:
<think>structured affective reasoning</think>
<answer>naturalised gold answer</answer>
SFT 在整个框架里承担三个职责。
15.1 学会统一输出格式
Section titled “15.1 学会统一输出格式”模型先稳定生成:
<think>...</think><answer>...</answer>15.2 学会跨任务共享的 affective reasoning
Section titled “15.2 学会跨任务共享的 affective reasoning”虽然最终输出空间不同,但 reasoning 可以共享:
negationsarcasmintensityemotion interactioncontextual polarity15.3 给 GRPO 一个足够好的起点
Section titled “15.3 给 GRPO 一个足够好的起点”GRPO 的 reward 是稀疏的。
如果初始模型大部分候选都错误:
0 0 0 0 0 0 0 0组内没有差异,就很难形成有效 relative advantage。
所以 SFT 的作用不是可有可无的预热,而是:
先把 policy 推到“有一定概率产生正确候选”的区域。
15.4 SFT 配置
Section titled “15.4 SFT 配置”| 配置 | 数值 |
|---|---|
| Framework | LLaMA-Factory |
| Base model | Qwen3-8B |
| Learning rate | 5 × 10^-6 |
| LR schedule | cosine + 0.1 warmup |
| Epochs | 3 |
| Per-device batch | 1 × 2 GPUs |
| Gradient accumulation | 8 |
| Max length | 8192 |
| Precision | bf16 |
| Distributed runtime | ZeRO-3 |
| Validation split | 10% |
---
16. 第二阶段:GRPO 做了什么
Section titled “16. 第二阶段:GRPO 做了什么”SFT 之后,作者继续使用 GRPO。
核心 reward:
R = 1.0 × r_acc + 0.1 × r_fmt其中:
r_acc ∈ {0, 1}表示是否满足任务 strict criterion。
r_fmt ∈ {0, 1}表示输出是否满足:
<think>...</think><answer>...</answer>GRPO 的流程可以简化为:
同一个 Prompt↓采样 G = 8 个 completion↓计算每个 completion 的 reward↓组内比较得到 relative advantage↓提高相对更好回答的概率↓降低相对更差回答的概率论文不需要单独训练 value network。
16.1 GRPO 配置
Section titled “16.1 GRPO 配置”| 配置 | 数值 |
|---|---|
| Framework | open-r1 / TRL |
| Learning rate | 1 × 10^-6 |
| Epochs | 2 |
| Batch | 2 |
| Gradient accumulation | 4 |
| Group size | 8 |
| Prompt max length | 4096 |
| Completion max length | 8192 |
| KL β | 0.01 |
| Temperature | 1.0 |
| Generation | vLLM colocated |
16.2 为什么 verifier 和 reward 要尽量闭环
Section titled “16.2 为什么 verifier 和 reward 要尽量闭环”理想状态下:
Reasoning synthesis 时什么叫“正确”=GRPO reward 里什么叫“正确”因此:
EI-reg:±0.05 → ±0.05V-reg :±0.05 → ±0.05V-oc :exact → exactE-c 是主要例外:
构造:F1 ≥ 0.7
RL:exact label-set
这也会影响后面的 reasoning-answer consistency。
---
17. 实验设置
Section titled “17. 实验设置”数据来自:
SemEval-2018 Task 1English训练总量:
16,302其中:
SFT = 5,388RL = 10,914官方测试集:
9,201具体为:
| 子任务 | 测试数量 |
|---|---|
| EI-reg | 4,068 |
| E-c | 3,259 |
| V-reg | 937 |
| V-oc | 937 |
split:
seed = 42主要对比方法包括:
SemEval competition systems├── SeerNet└── NTUA-SLP
Pretrained Models├── BERT├── RoBERTa└── SentiBERT
Zero / Few-shot LLM├── Falcon├── Vicuna├── LLaMA2├── ChatGPT└── GPT-4
EmoLLM family├── EmoBART├── EmoT5├── EmoOPT├── EmoBLOOM└── EmoLLaMA
headline metrics:
EI-reg → Pearson rV-reg → Pearson rV-oc → Pearson rE-c → Jaccard + micro-F1 + macro-F1---
18. Main Results 应该怎么解读
Section titled “18. Main Results 应该怎么解读”论文最亮眼的结果在:
EI-reg18.1 EI-reg
Section titled “18.1 EI-reg”NTDH RL-final:
Pearson = 0.862对比:
EmoLLaMA-chat-13B = 0.831SeerNet = 0.799这是表中最强结果。
18.2 V-reg
Section titled “18.2 V-reg”NTDH:
0.840最强 baseline:
EmoOPT = 0.887差:
0.04718.3 V-oc
Section titled “18.3 V-oc”NTDH:
0.831最强 baseline:
EmoLLaMA-chat-13B = 0.860差:
0.02918.4 E-c
Section titled “18.4 E-c”NTDH Jaccard:
0.579对比:
SeerNet = 0.609Best EmoLLM (EmoT5) = 0.559所以更准确的结论是:
EI-reg:最强V-reg:有竞争力,但不是最强V-oc :有竞争力,但不是最强E-c :表中第二梯队,超过最好 EmoLLM,但低于 SeerNet因此不能简单总结成:
NTDH 全任务 SOTA更合理的表述是:
NTDH 在 EI-reg 上取得最强表现,并在其他异构情感任务上保持有竞争力的统一推理能力。
---
19. SFT → GRPO 到底有没有用
Section titled “19. SFT → GRPO 到底有没有用”这是评价第二阶段 RL 最直接的一组对照。
| 指标 | SFT init | RL-final | 变化 |
|---|---|---|---|
| EI-reg Pearson | 0.800 | 0.862 | +0.062 |
| V-reg Pearson | 0.785 | 0.840 | +0.055 |
| V-oc Pearson | 0.785 | 0.831 | +0.046 |
| E-c Jaccard | 0.557 | 0.579 | +0.022 |
| E-c micro-F1 | 0.667 | 0.677 | +0.010 |
| E-c macro-F1 | 0.555 | 0.543 | -0.012 |
即:
6 个 headline 指标↓5 个提升1 个下降唯一下降的是:
E-c macro-F10.555 → 0.543macro-F1 对每个标签等权,因此它暴露出一个问题:
整体预测变好,并不代表少数、低频情绪类别也同步变好。
---
20. N / T / D / H 消融到底说明了什么
Section titled “20. N / T / D / H 消融到底说明了什么”20.1 N:最直接的 target quality 杠杆
Section titled “20.1 N:最直接的 target quality 杠杆”不用 Naturalisation:
只有约 18.4% 初始 candidate落在 gold tolerance 内使用 Naturalisation 后:
所有 retained SFT answer都来自 gold20.2 T:把 verifier 的错误接受打到 0
Section titled “20.2 T:把 verifier 的错误接受打到 0”换回 LLM Judge:
EI-reg 超容差错误接受:62.7%V-reg 超容差错误接受:47.5%deterministic gate:
0%20.3 D:总体提升有限,但 E-c 明显
Section titled “20.3 D:总体提升有限,但 E-c 明显”总体 convergence:65% → 66%
E-c:46% → 56%但这只是:
matched 320-instance单次 re-synthesis所以稳定性仍需更多实验。
20.4 H:主要价值是消除 leakage
Section titled “20.4 H:主要价值是消除 leakage”Directional Hint 代替:
直接把 gold answer 注入 prompt最终:
Low tier 为空20.5 我的理解
Section titled “20.5 我的理解”可以把四个模块按重要性理解为:
N + T:解决“数据正确性”
H:解决“监督可信性”
D:解决“领域 reasoning 质量”
其中 N、T 是最硬的基础组件。
---
21. 为什么作者强调“数据质量 > 数据数量”
Section titled “21. 为什么作者强调“数据质量 > 数据数量””NTDH 总训练记录:
16,302EmoLLM AAID:
约 234K大约是 NTDH 的:
14 倍但真正带 CoT 用于 SFT 的 NTDH 数据只有:
5,388即使如此,NTDH 仍在 EI-reg 上取得最强结果。
作者的解释与 GRPO 的 reward 特性有关。
21.1 Binary reward 的 Zero-variance Group
Section titled “21.1 Binary reward 的 Zero-variance Group”假设:
group size = 8如果一组 reward 是:
0 0 0 0 0 0 0 0所有回答都错。
没有组内差异。
如果:
1 1 1 1 1 1 1 1所有回答都对。
同样没有组内差异。
只有类似:
0 0 1 0 1 0 0 1才真正形成:
relative advantage论文的 proxy estimate 显示:
E-c zero-variance groups = 77.1%V-reg zero-variance groups = 75.7%也就是说,多数组可能根本不给 GRPO 有效区分信号。
因此:
坏的 SFT policy↓大部分 group 全错↓binary reward 没方差↓GRPO 没有足够梯度↓很难靠 RL 自动救回来这就是作者强调数据质量的核心原因:
在稀疏、可验证 reward 下,先把 SFT policy 放到正确区域,比简单堆更多低质量 reasoning 数据更重要。
---
22. Error Analysis:模型还会在哪里失败
Section titled “22. Error Analysis:模型还会在哪里失败”论文总结了三个很典型的问题。
22.1 E-c:Reasoning–Answer Inconsistency
Section titled “22.1 E-c:Reasoning–Answer Inconsistency”某些样本中:
reasoning 已经提到了 anticipation / optimism但最终 answer 却:
漏掉这些标签并额外加入 disgust这说明:
reasoning 局部合理≠最终 answer 忠实执行 reasoning22.2 V-oc:混合 valence 被机械“平均成中性”
Section titled “22.2 V-oc:混合 valence 被机械“平均成中性””例如:
YAY, that's awesome ...it makes me sad you're leavingGold:
-2Prediction:
0模型把:
positive cue+negative cue机械抵消为 neutral。
真正需要的是:
cue weighting而不是:
cue averaging22.3 V-reg:对 sarcasm cue 过度修正
Section titled “22.3 V-reg:对 sarcasm cue 过度修正”例如:
The fun never stops. 🙃 #sarcasmGold:
0.392Pred:
-0.266模型看到:
#sarcasm后发生了过强 polarity reversal。
说明:
domain cue 不能被当成 deterministic label flip。
仍然需要结合:
contextconfidencecue strength---
23. 论文最关键的局限
Section titled “23. 论文最关键的局限”23.1 E-c 的 permissive verifier 会造成 reasoning-answer mismatch
Section titled “23.1 E-c 的 permissive verifier 会造成 reasoning-answer mismatch”构造阶段:
F1 ≥ 0.7就允许 reasoning 通过。
但 Naturalisation 会配上完整 gold label set。
因此:
reasoning 可能只支持部分 gold↓answer 却写入完整 gold这意味着部分 rationale 不一定 fully faithful。
23.2 Binary reward 太稀疏
Section titled “23.2 Binary reward 太稀疏”回归任务中:
0.5010.549只要都进入 ±0.05:
reward = 1模型不知道谁更接近 gold。
同理,多标签 exact match 也忽略:
差一个标签和:
差很多标签之间的区别。
23.3 D 的整体贡献仍缺乏充分验证
Section titled “23.3 D 的整体贡献仍缺乏充分验证”总体 convergence:
65% → 66%变化很小。
E-c 的 +10pt 有价值,但实验规模有限,需要 repeated runs。
23.4 Benchmark 较旧且单一
Section titled “23.4 Benchmark 较旧且单一”实验主要集中在:
SemEval-2018EnglishTask 1论文虽然提出可以推广到:
graded relevanceordinal stancemulti-label tagging但并没有跨 benchmark 实证。
---
24. 这篇论文真正的创新在哪里
Section titled “24. 这篇论文真正的创新在哪里”这篇论文没有首创:
Chain-of-ThoughtSFT → RLGRPOQwen3-8BVerifier-based Reward因此不能把贡献说成:
提出了一种新的 RL 算法更准确的贡献边界是:
24.1 统一任务 formulation
Section titled “24.1 统一任务 formulation”把:
regressionordinal classificationmulti-label classification统一成:
structured conditional generation24.2 提出 NTDH reasoning data pipeline
Section titled “24.2 提出 NTDH reasoning data pipeline”N + T + D + H围绕:
targetverifierrefinementfallback四个环节控制 reasoning data quality。
24.3 尽量统一 verifier 与 RL reward
Section titled “24.3 尽量统一 verifier 与 RL reward”让:
“什么 reasoning 能进 SFT”和:
“GRPO 什么答案拿 reward”尽量采用同一套 task criterion。
24.4 Hard cases 不丢弃
Section titled “24.4 Hard cases 不丢弃”unconverged Half-A+Half-B↓GRPO失败样本仍然有训练价值。
24.5 证明“少而干净”的 reasoning corpus 可以很有效
Section titled “24.5 证明“少而干净”的 reasoning corpus 可以很有效”尤其在 EI-reg 上:
NTDH RL-final = 0.862说明高质量 reasoning supervision 与可验证 RL 的组合具有实际效果。
---
25. 如果继续改,这篇论文最自然的方向是什么
Section titled “25. 如果继续改,这篇论文最自然的方向是什么”根据现有问题,可以推导出四个很直接的改进方向。
25.1 Shaped Reward
Section titled “25.1 Shaped Reward”不要只使用:
0 / 1对于 regression,可以考虑:
离 gold 越近↓reward 越高例如:
distance-aware reward对于 multi-label,可以使用:
soft-F1 reward代替纯 exact set reward。
这样可以降低:
zero-variance group问题。
25.2 Reasoning → Answer Consistency Gate
Section titled “25.2 Reasoning → Answer Consistency Gate”在 reasoning 通过后,再检查:
reasoning 中支持了哪些 emotion↓answer 是否真正由 reasoning 推出避免:
reasoning 说了 A / B / Canswer 却输出 A / D25.3 Quality-weighted SFT
Section titled “25.3 Quality-weighted SFT”真正利用:
GoldSilverBronze的 quality tier。
例如:
Gold → weight 1.0Silver → weight 0.8Bronze → weight 0.5而不是所有 trace 等权。
25.4 更广泛的 benchmark
Section titled “25.4 更广泛的 benchmark”验证:
不同语言不同数据域不同情感 benchmark不同 ordinal / multi-label 任务才能证明 NTDH 是一个真正通用的 reasoning data recipe。
---
26. 复现时最需要记住的配置
Section titled “26. 复现时最需要记住的配置”26.1 数据
Section titled “26.1 数据”SemEval-2018 Task 1
Total Train = 16,302
Half-A = 8,150Half-B = 8,152
SFT = 5,388RL = 10,914
Test = 9,20126.2 SFT
Section titled “26.2 SFT”Model = Qwen3-8BFramework = LLaMA-FactoryFull-parameter Fine-tuning
LR = 5e-6Epoch = 3Grad Acc = 8Max Length = 8192bf16ZeRO-326.3 GRPO
Section titled “26.3 GRPO”Framework = open-r1 / TRL
LR = 1e-6Epoch = 2Batch = 2Grad Acc = 4
Group Size = 8KL β = 0.01Temperature = 1.0
Prompt Length = 4096Completion Length = 819226.4 Reward
Section titled “26.4 Reward”R = 1.0 × r_acc + 0.1 × r_fmt其中:
EI-reg / V-reg:|ŷ-y| ≤ 0.05
V-oc:exact class
E-c:exact label-set
Format:<think>...</think><answer>...</answer>
---
27. 我对 NTDH 的阶段性理解
Section titled “27. 我对 NTDH 的阶段性理解”完成这次梳理之后,我认为这篇论文最重要的不是某一个模块,而是它把 reasoning model 的训练拆成了几个必须分别控制的环节:
Gold target 是否可信?↓Verifier 是否真的对应任务标准?↓Reasoning 错了以后应该怎么修?↓修正过程中有没有泄漏标签?↓哪些 reasoning 可以进 SFT?↓哪些 hard cases 应该交给 RL?↓RL reward 是否与前面的 verifier 一致?以前很容易把:
生成 CoT+SFT+GRPO理解成一个简单流水线。
NTDH 更值得借鉴的地方是:
CoT 不是生成出来就能直接训练,reasoning data 本身也需要被验证、筛选和治理。
这对任何可验证 reasoning 任务都有一定启发。
如果任务能把最终答案写成可计算标准,那么一个比较稳健的设计思路是:
结构化答案↓确定性 verifier↓高质量 reasoning synthesis↓SFT 初始化↓可验证 RL---
28. 总结
Section titled “28. 总结”整篇论文可以压缩成下面这条主线:
异构情感任务↓统一成 structured generation↓N:用 gold Naturalisation 保证最终监督目标正确↓T:用 task-specific verifier 保证验证标准正确↓D:用 affective knowledge 修正失败 reasoning↓H:只给方向提示,避免 label leakage↓得到 verified reasoning traces↓5,388 条用于 full-parameter SFT↓10,914 条用于 GRPO↓6 个 headline 指标提升 5 个↓EI-reg Pearson 达到 0.862我目前最核心的理解是:
NTDH 的贡献不是让模型“多想几步”,而是系统回答了:哪些 reasoning 值得训练、如何验证 reasoning、失败样本如何修正、以及 SFT 与 RL 的标准如何保持一致。
它最强的地方在于:
数据质量控制+任务特定 verifier+SFT → GRPO 的闭环它目前最明显的问题则在于:
E-c reasoning-answer consistencybinary sparse rewardrare-label performance单一 benchmark因此,如果继续沿着这条路线做,最自然的方向不是单纯增加更多 CoT,而是继续提高:
reward 的连续性reasoning 与 answer 的一致性quality-aware supervision跨数据集泛化能力---
29. 一句话记住这篇论文
Section titled “29. 一句话记住这篇论文”NTDH = 先把 reasoning 数据做对,再让 SFT 学会 reasoning,最后用可验证 GRPO 把 reasoning policy 继续推好。