iLLaDA——双向扩散语言模型如何逼近自回归大模型
本文记录我学习 iLLaDA(Improved Large Language Diffusion Models) 的过程。
这篇工作的核心问题可以概括成一句话:
语言模型的通用能力,是否一定依赖从左到右的自回归建模?传统大语言模型通常采用:
前面已经生成的 token↓预测下一个 token↓再把新 token 接到后面↓继续预测而 iLLaDA 走的是另一条路线:
随机 Mask 一部分 token↓使用双向 Transformer 同时预测被遮挡位置↓多轮去噪↓逐步恢复完整序列这次学习最想弄清楚的不是“扩散语言模型是什么”这个抽象定义,而是下面几个更具体的问题:
- iLLaDA 和自回归语言模型的根本差别是什么?
- 自回归 causal attention 和 iLLaDA 双向 attention 的可见范围有什么区别?
- 双向 attention 为什么不会泄露被 Mask 的正确答案?
- 它为什么不是一个“更大的 BERT”?
- 训练里的
t和1/t分别有什么作用? - iLLaDA 相比 LLaDA 到底改了哪些东西?
- 为什么 SFT 阶段连 Prompt 和 EOS 都可以被 Mask?
- EOS 为什么会直接决定可变长度生成能不能成立?
- 推理时为什么是“块内并行、块间顺序”?
- 选择题为什么需要 Confidence Scoring,而不是直接照搬传统 likelihood?
- iLLaDA 在 Base 模型和 Instruct 模型上的实际表现到底怎么样?
- SFT 训练更久是否还有效?
---
1. 先看整篇论文的主线
Section titled “1. 先看整篇论文的主线”iLLaDA 的完整训练与推理流程可以先看下面这张总图:
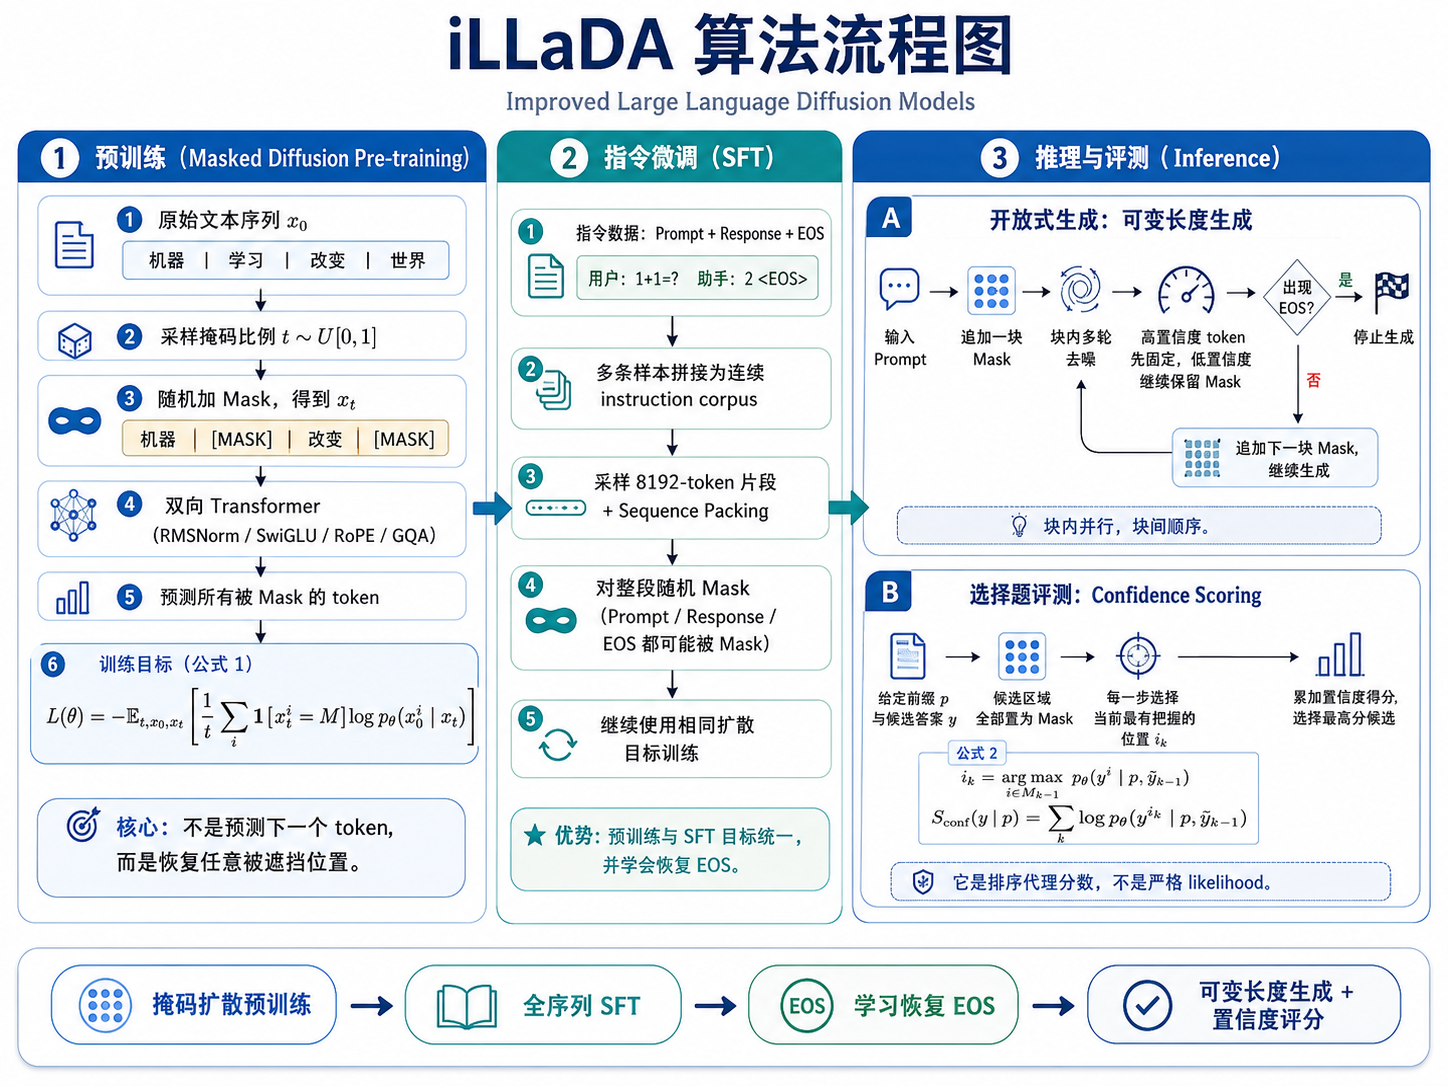
如果把这张图压缩成文字,可以写成:
普通文本↓不使用 causal 下三角限制,采用双向 Attention↓掩码扩散预训练↓双向 Transformer 学会恢复任意被 Mask 的位置↓全序列 Instruction SFT↓Prompt / Response / EOS 都可能被 Mask↓模型学会恢复 EOS↓开放式生成:可变长度 block-wise 去噪↓选择题评测:Confidence Scoring所以 iLLaDA 并不是只改了一个推理算法。
它实际上把:
预训练SFTEOS 学习开放式生成选择题打分组织成了一套统一的扩散语言模型方案。
我目前对这篇论文最简洁的理解是:
iLLaDA 的关键不是重新发明扩散目标,而是把“扩散预训练”真正延伸到了指令微调、可变长度生成和评测阶段。
---
2. 自回归 Attention 和 iLLaDA 双向 Attention 到底差在哪里
Section titled “2. 自回归 Attention 和 iLLaDA 双向 Attention 到底差在哪里”8 月 7 日这版 PPT 新增了一个很关键的解释:iLLaDA 的“双向”到底体现在哪里?
假设序列是:
法国 | 的 | 首都 | 是 | 巴黎 | 。一共有 6 个位置。
2.1 自回归 Transformer 的可见范围
Section titled “2.1 自回归 Transformer 的可见范围”传统自回归 Transformer 在预测位置 i 时,只允许查看:
位置 1 ~ i也就是说,第 4 个位置不能看到第 5、6 个位置。
它的可见矩阵是:
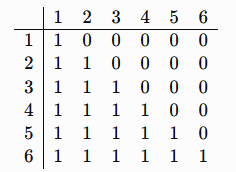
矩阵中:
1 = 可以看0 = 不允许看所以它呈现为一个典型的下三角结构。
对应的 causal attention mask 可以写成:
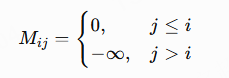
直觉上就是:
j ≤ i→ 允许注意
j > i→ 加上 -∞
然后进入 Softmax:
exp(-∞) = 0因此未来位置的注意力概率最终会变成:
0也就是说,自回归模型在结构上强制:
只能看当前 token 左边已经出现的内容2.2 iLLaDA 的双向 Transformer
Section titled “2.2 iLLaDA 的双向 Transformer”iLLaDA 不使用这种下三角限制。
它的可见矩阵变成:
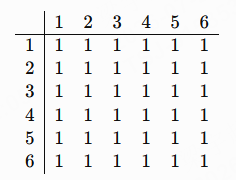
可以看到:
每一个位置↓都可以查看当前整条序列所以,当模型恢复某一个 Mask 时,可以同时利用:
左边的可见 token+右边的可见 token例如:
法国 [MASK] 首都 [MASK] 巴黎 。恢复第 2 个位置时,模型不仅可以看:
法国还可以看右边已经可见的:
首都巴黎。这就是 iLLaDA 所说的:
bidirectional context2.3 这样会不会“偷看答案”
Section titled “2.3 这样会不会“偷看答案””第一反应很容易是:
既然位置 2 可以看位置 4、5、6,那不是把未来答案泄露了吗?关键在于:
模型看到的是当前被破坏后的序列
x_t,不是原始完整序列x_0。
如果某个位置已经被 Mask,那么该位置在模型输入中只是:
[MASK]模型能看到的是:
[MASK] embedding而不是这个位置原来的正确 token。
例如原句:
法国 的 首都 是 巴黎 。被破坏成:
法国 [MASK] 首都 [MASK] 巴黎 。模型虽然允许每个位置彼此注意,但它实际看到的是:
位置 1:法国位置 2:[MASK]位置 3:首都位置 4:[MASK]位置 5:巴黎位置 6:。因此位置 2 可以利用:
法国首都巴黎。但它并不能直接看到原始答案:
“的”同理,位置 4 也只能看到:
[MASK]而不是正确答案:
“是”所以:
双向 Attention≠直接读取被 Mask 的 gold token更准确的理解是:
AR:通过 causal mask 阻止查看右侧位置
iLLaDA:允许查看左右两侧,但未知位置已经被替换为 [MASK]
这也是自回归模型和掩码扩散模型在建模方式上的核心结构差异之一。
---
3. 自回归和扩散语言模型到底差在哪里
Section titled “3. 自回归和扩散语言模型到底差在哪里”可以先用一句非常简单的话理解。
2.1 自回归模型学什么
Section titled “2.1 自回归模型学什么”假设模型要生成:
北京是中国的首都自回归模型的生成过程类似:
北京↓北京是↓北京是中国的↓北京是中国的首都它学习的是:
P(x_i | x_1, x_2, ..., x_{i-1})即:
已经看到左边这些 token 之后,下一个 token 最可能是什么?
因此,第 i 个 token 的预测依赖左侧已经出现的上下文。
2.2 iLLaDA 学什么
Section titled “2.2 iLLaDA 学什么”同一句话可以先被破坏成:
北京 是 [MASK] 的 [MASK]然后模型尝试恢复:
第 3 个位置 → 中国第 5 个位置 → 首都这里的目标不再是:
预测“下一个词”而是:
恢复“任意一个被遮挡的位置”因为 Transformer 是双向的,所以一个 Mask 位置可以利用:
左侧上下文+右侧上下文进行恢复。
因此两类模型最核心的差别可以概括为:
AR:往后接什么?
iLLaDA:哪里被挡住了,以及这里应该补什么?
---
4. 掩码扩散预训练是怎么做的
Section titled “4. 掩码扩散预训练是怎么做的”假设原句是:
机器 学习 改变 世界首先从:
t ~ U[0,1]采样一个 Mask 比例。
假设本次:
t = 0.5那么可能随机得到:
机器 [MASK] 改变 [MASK]模型需要恢复:
位置 2 = 学习位置 4 = 世界这里有一个很重要的点:
损失只在被 Mask 的位置上计算。
也就是说,本轮训练重点不是再次预测已经可见的:
机器改变而是要求模型根据当前完整上下文恢复:
学习世界---
5. iLLaDA 的扩散训练目标怎么理解
Section titled “5. iLLaDA 的扩散训练目标怎么理解”PPT 中给出的目标函数如下:
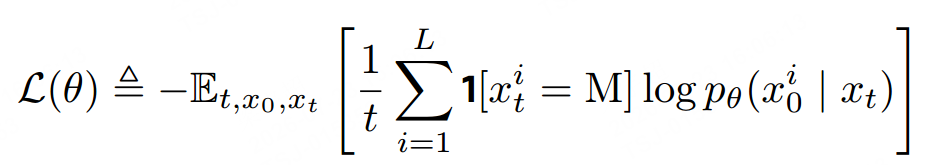
可以写成:
不需要一开始就把公式看得很复杂。
可以先拆成四部分。
4.1 x0
Section titled “4.1 x0”x0 = 原始完整文本例如:
机器 学习 改变 世界4.2 xt
Section titled “4.2 xt”xt = 按照噪声强度 t 加 Mask 后的文本例如:
机器 [MASK] 改变 [MASK]4.3 指示函数
Section titled “4.3 指示函数”1[x_t^i = M]意思是:
只有当前位置被 Mask 时,这个位置才进入当前 loss。4.4 log pθ(x0^i | xt)
Section titled “4.4 log pθ(x0^i | xt)”表示:
给定当前被破坏的序列 xt,模型给原始正确 token 的概率有多大。所以整个训练目标可以压缩成:
随机破坏文本↓只检查被破坏的位置↓要求模型把原 token 恢复回来---
6. 为什么 t 要从 U[0,1] 中随机采样
Section titled “6. 为什么 t 要从 U[0,1] 中随机采样”这是理解 diffusion LM 的一个关键点。
如果 t 很小:
只有很少 token 被 Mask任务相对容易。
例如:
机器 学习 [MASK] 世界模型有大量可见上下文。
如果 t 中等:
一部分 token 被 Mask模型需要更明显地依赖双向上下文。
如果 t 很大:
绝大部分 token 都被 Mask就逐渐接近:
从几乎全 Mask 的状态恢复完整文本因此随机采样:
t ~ U[0,1]相当于让模型在训练时同时接触:
低噪声任务中噪声任务高噪声任务这对后面真正从大量 Mask 开始生成很重要。
---
7. 为什么公式前面还有一个 1/t
Section titled “7. 为什么公式前面还有一个 1/t”直觉上:
t 越大↓被 Mask 的位置越多↓参与 loss 的 token 也越多如果完全不做调整,那么:
高 t 样本天然会产生更大的 loss。
因此公式中加入:
1 / t让不同 Mask 强度下的损失规模更可比较。
可以把它理解为:
Mask 很少→ 每个被 Mask token 贡献正常权重
Mask 很多→ 用 1/t 做归一化→ 避免高噪声样本仅仅因为 Mask 数量更多而主导训练
这里最重要的不是记住公式,而是记住它解决的问题:
不同噪声强度下,被监督的位置数量不同,需要做尺度上的平衡。
---
8. iLLaDA 为什么不是“更大的 BERT”
Section titled “8. iLLaDA 为什么不是“更大的 BERT””表面上看:
BERT:Mask token → 恢复 token
iLLaDA:Mask token → 恢复 token
似乎很像。
但训练目标和最终用途不同。
典型理解是:
固定或较小比例 Mask↓Masked Language Modeling↓学习高质量双向文本表征重点更偏向:
representation learningiLLaDA
Section titled “iLLaDA”iLLaDA 覆盖:
从低噪声↓到高噪声的很多状态。
并且训练目标最终直接服务于:
多轮去噪生成所以可以做一个最简对比:
| 模型 | 主要训练方式 | 典型生成/用途 |
|---|---|---|
| BERT | 小比例 Mask 恢复 | 表征学习 |
| AR LLM | 左到右预测下一个 token | 自回归生成 |
| iLLaDA | 随机 Mask 强度 + 任意位置恢复 | 多轮扩散去噪生成 |
因此:
“都用了 Mask”并不意味着 BERT 和 diffusion LM 是同一种生成模型。
---
9. iLLaDA 相比 LLaDA 到底改了什么
Section titled “9. iLLaDA 相比 LLaDA 到底改了什么”PPT 中给出的关键配置包括:
模型规模:8B
预训练 tokens:12T
最大上下文:8192
GQA:32 Query Heads8 KV Heads
Embedding / LM Head:Tied
相比此前 LLaDA,iLLaDA 主要做的是更成熟的训练配方。
8.1 更大的训练数据
Section titled “8.1 更大的训练数据”LLaDA:约 2.3T tokensiLLaDA:12T tokens8.2 更长上下文
Section titled “8.2 更长上下文”最大上下文长度 = 81928.3 长短样本混合
Section titled “8.3 长短样本混合”论文使用:
30% 概率把一个 8192-token 序列拆成两个较短片段。
8.4 Sequence Packing
Section titled “8.4 Sequence Packing”通过:
sequence packing+variable-length attention提高不同长度训练样本的利用率。
8.5 Learning Rate 策略
Section titled “8.5 Learning Rate 策略”当训练 loss 出现停滞后:
constant LR↓cosine decay从论文的定位来看,这些改动大多不是新的理论机制。
更准确的评价是:
iLLaDA 把 LLaDA 从“证明双向扩散语言模型路线可行”进一步推进成了一套更成熟、更像大规模 LLM 的训练方案。
---
10. SFT 最大的变化:整段序列都可能被 Mask
Section titled “10. SFT 最大的变化:整段序列都可能被 Mask”传统指令微调可以想象成:
用户:1+1 等于多少?助手:2。很多生成式训练会重点监督 Response。
而在 iLLaDA 中,作者先把多条指令样本拼起来:
用户:1+1 等于多少?助手:2。<EOS>
用户:法国首都是哪里?助手:巴黎。<EOS>
...
然后:
拼接为连续 instruction corpus↓截取 8192-token 训练片段↓对整段随机 Mask于是下面这些部分都可能被 Mask:
PromptResponseEOS例如可能得到:
用户:法国 [MASK] 首都是哪里?助手:[MASK]。[MASK]
用户:1+1 等于多少?[MASK]:2。<EOS>
所以 iLLaDA 的 SFT 并不是:
只学习如何补 Response而是:
在完整 instruction sequence 上继续使用和预训练相同的扩散恢复目标这带来一个很重要的好处:
预训练和 SFT 使用的是同一套掩码扩散学习范式。
---
11. 为什么 EOS 是可变长度生成的关键
Section titled “11. 为什么 EOS 是可变长度生成的关键”这是 iLLaDA 很有意思的一点。
在 SFT 中:
真实 EOS 被保留下来↓EOS 也可能被 Mask↓模型需要学习恢复 EOS于是模型不仅学习:
某个位置应该是什么词也学习:
这里应该结束了假设 Prompt 是:
请用一句话介绍牛顿。推理时模型先添加一块 Mask:
[MASK] [MASK] [MASK] [MASK] ...经过块内多轮去噪之后,可能恢复为:
牛顿是经典力学的重要奠基人。<EOS>一旦发现:
<EOS>系统就可以停止生成。
因此不再需要预先规定:
这个回答一定生成 32 token这个回答一定生成 128 token模型可以自己学会:
回答什么时候结束所以:
SFT 阶段让 EOS 参与 Mask 与恢复,不是一个孤立的小技巧,而是在训练阶段为 variable-length generation 建立能力。
---
12. 开放式生成:块内并行,块间顺序
Section titled “12. 开放式生成:块内并行,块间顺序”iLLaDA 的开放式生成并不是:
一次性把整篇回答全部生成出来而是采用 block-wise 的方式。
流程可以理解成:
Prompt↓追加一块 Mask↓同时预测当前块内所有 Mask↓选择高置信度 token 先固定↓低置信度位置继续保持 Mask↓下一轮重新预测↓当前块逐渐被恢复↓检查 EOS如果:
出现 EOS则:
停止生成如果没有:
追加下一块 Mask↓继续生成所以生成结构是:
块内部:并行预测 / 多轮去噪
块之间:顺序追加
更准确的描述不是:
完全非自回归而是:
semi-autoregressive或者:
block-wise generation---
13. 一个完整示例:法国的首都是哪里
Section titled “13. 一个完整示例:法国的首都是哪里”PPT 第 3 页把预训练、SFT、生成和选择题评分放到了同一个例子中:
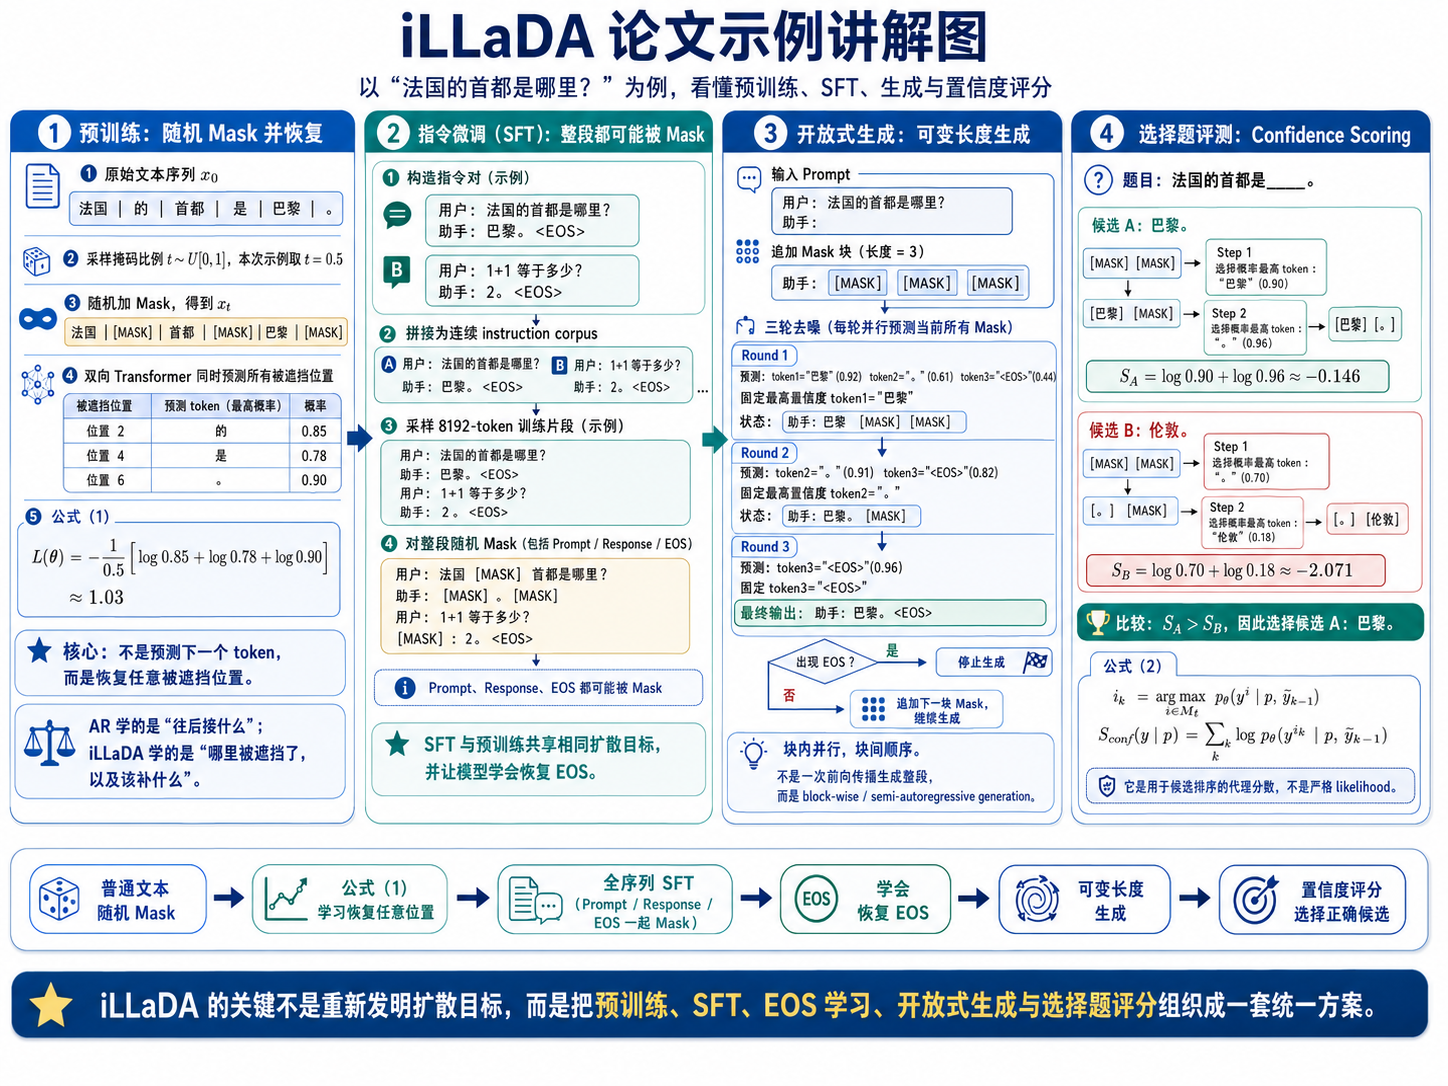
假设原始文本是:
法国 的 首都 是 巴黎 。12.1 预训练阶段
Section titled “12.1 预训练阶段”随机 Mask:
法国 [MASK] 首都 [MASK] 巴黎 [MASK]双向 Transformer 同时预测所有被挡位置。
例如得到:
位置 2 → 的位置 4 → 是位置 6 → 。模型学到的不是:
“巴黎”的下一个 token 是什么而是:
在当前左右上下文下,每一个被 Mask 位置应该恢复成什么。12.2 SFT 阶段
Section titled “12.2 SFT 阶段”构造:
用户:法国的首都是哪里?助手:巴黎。<EOS>然后对整段随机 Mask。
Prompt、Response、EOS 都可以进入预测目标。
12.3 开放式生成
Section titled “12.3 开放式生成”Prompt:
用户:法国的首都是哪里?助手:追加 Mask 块,例如:
[MASK] [MASK] [MASK]第 1 轮:
模型同时预测所有 Mask
“巴黎”置信度最高↓先固定“巴黎”
第 2 轮:
在“巴黎”已经可见的条件下重新预测剩余 Mask↓固定“。”第 3 轮:
预测 <EOS>↓停止最终:
巴黎。<EOS>这就是:
高置信度位置先确定↓新上下文帮助剩余位置↓逐轮去噪---
14. 为什么不同任务还要调 block length
Section titled “14. 为什么不同任务还要调 block length”由于 iLLaDA 的开放式生成采用:
一块一块追加 Mask因此 block length 会直接影响:
一次并行预测多少位置如果 block 很大:
并行度更高但一开始每个位置可利用的已确定上下文相对更少。
如果 block 较小:
块间顺序步骤更多但每个新块可以利用前面已经恢复出来的更多上下文。
所以:
block length本身就是:
并行性vs逐步条件化之间的折中。
这也是为什么论文中的扩散生成不能简单理解为:
所有 token 同时一次生成完成---
15. 选择题为什么不能直接照搬 AR likelihood
Section titled “15. 选择题为什么不能直接照搬 AR likelihood”对于传统自回归模型,一个候选答案的 likelihood 很自然地写成:
从左到右逐 token 计算条件概率↓累加 log probability但 iLLaDA 是双向去噪模型。
它没有一个天然固定的:
从左到右 factorization因此论文提出了:
Confidence Scoring核心思路是:
不是强行规定从左到右评分↓而是按照模型自己最有把握的揭示顺序评分---
16. Confidence Scoring 是怎么计算的
Section titled “16. Confidence Scoring 是怎么计算的”假设给定:
Prompt p+某个候选答案 y最开始把候选区域视为 Mask。
每一步模型都会看当前还未揭示的位置:
M_{k-1}然后找到:
当前最有把握的位置可以写成:
也就是:
第 k 步↓从仍然 Mask 的位置中↓选出对正确 token 置信度最高的位置↓先揭示它然后不断重复:
揭示一个高置信度位置↓形成更多上下文↓再给剩余位置打分最终 Confidence Score 是这些揭示步骤的 log probability 累加:
所以它更像:
沿着模型自己最自然的去噪顺序,对候选答案进行排序。
论文也特别强调:
它是 ranking proxy score而不是传统自回归意义上的严格序列 likelihood。
---
17. Confidence Scoring 实际有提升吗
Section titled “17. Confidence Scoring 实际有提升吗”PPT 给出的选择题结果如下:
| Scoring rule | PIQA | ARC-C | HellaSwag |
|---|---|---|---|
| Likelihood | 77.2 | 60.2 | 74.3 |
| Confidence | 78.5 | 60.8 | 76.6 |
变化分别是:
PIQA:77.2 → 78.5+1.3
ARC-C:60.2 → 60.8+0.6
HellaSwag:74.3 → 76.6+2.3
三个任务全部提升。
其中提升最大的是:
HellaSwag +2.3因此这组实验说明:
对于扩散语言模型,评测打分方式需要尊重模型自己的生成结构;直接套用传统 likelihood 不一定是最合适的排序方式。
---
18. Base Model 的实验结果怎么看
Section titled “18. Base Model 的实验结果怎么看”PPT 第 12 页给出了 Base Model 的结果:
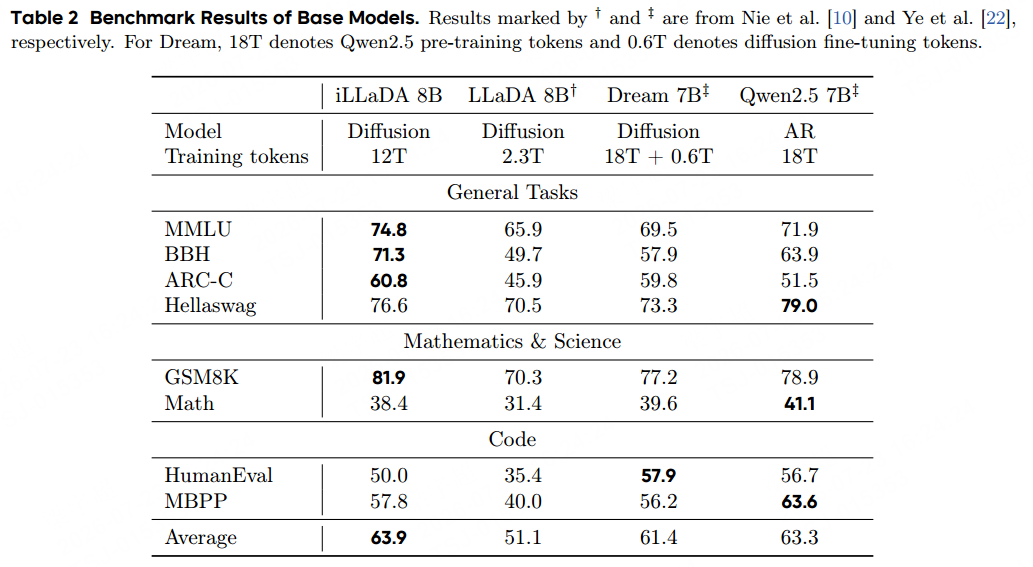
模型包括:
iLLaDA 8BLLaDA 8BDream 7BQwen2.5 7B其中:
iLLaDA:Diffusion12T tokens
LLaDA:Diffusion2.3T tokens
Dream:Diffusion18T + 0.6T
Qwen2.5:AR18T tokens
主要结果如下。
| Benchmark | iLLaDA 8B | LLaDA 8B | Dream 7B | Qwen2.5 7B |
|---|---|---|---|---|
| MMLU | 74.8 | 65.9 | 69.5 | 71.9 |
| BBH | 71.3 | 49.7 | 57.9 | 63.9 |
| ARC-C | 60.8 | 45.9 | 59.8 | 51.5 |
| HellaSwag | 76.6 | 70.5 | 73.3 | 79.0 |
| GSM8K | 81.9 | 70.3 | 77.2 | 78.9 |
| Math | 38.4 | 31.4 | 39.6 | 41.1 |
| HumanEval | 50.0 | 35.4 | 57.9 | 56.7 |
| MBPP | 57.8 | 40.0 | 56.2 | 63.6 |
| Average | 63.9 | 51.1 | 61.4 | 63.3 |
这里最值得注意的是:
iLLaDA Average = 63.9
Qwen2.5 7B Average = 63.3
也就是说,在这张 Base Model 表中:
iLLaDA 的总体平均分已经和强 AR baseline 非常接近,甚至略高。而且 iLLaDA 在:
MMLUBBHARC-CGSM8K上取得了表中最高分。
但它并不是所有任务都领先。
例如:
HellaSwag:76.6 < 79.0
Math:38.4 < 41.1
MBPP:57.8 < 63.6
所以更准确的结论是:
iLLaDA 的 Base Model 已经证明双向扩散预训练可以获得非常有竞争力的通用能力,但不同任务上仍存在明显强弱项。
---
19. iLLaDA 相比 LLaDA 提升有多大
Section titled “19. iLLaDA 相比 LLaDA 提升有多大”如果只比较:
iLLaDA 8BvsLLaDA 8B平均分是:
51.1↓63.9提升:
+12.8一些任务的变化尤其明显:
MMLU:65.9 → 74.8
BBH:49.7 → 71.3
ARC-C:45.9 → 60.8
GSM8K:70.3 → 81.9
HumanEval:35.4 → 50.0
MBPP:40.0 → 57.8
这支持 PPT 中对 iLLaDA 的定位:
不是简单提出另一套新理论而是:
通过更成熟的大模型训练 recipe,把原本的 diffusion LM 能力明显往前推进。不过这里也要注意:
训练数据量从 2.3T 增加到 12T因此不能把所有提升都归因于某一个单独结构改动。
---
20. Instruct Model 的结果要更谨慎地看
Section titled “20. Instruct Model 的结果要更谨慎地看”PPT 第 13 页给出了指令模型结果:
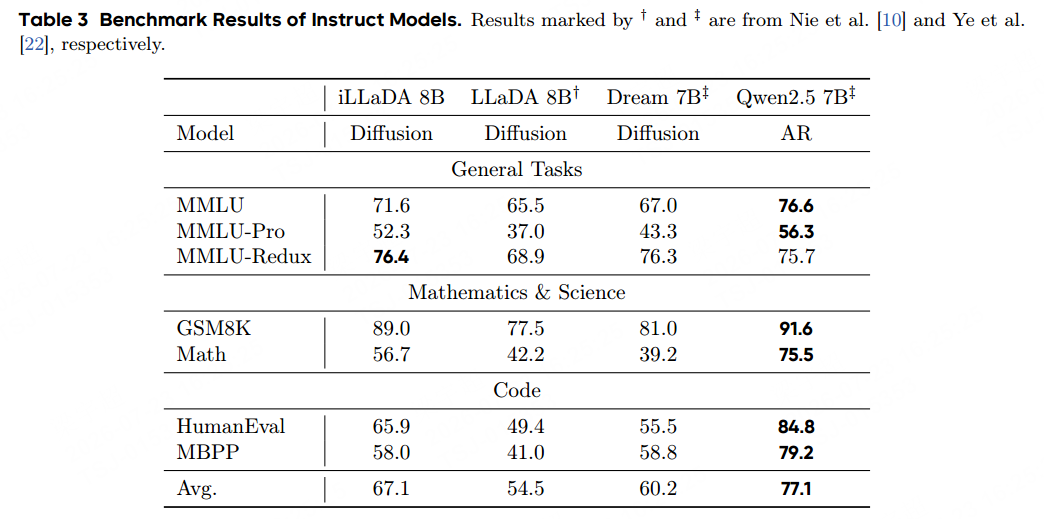
结果如下。
| Benchmark | iLLaDA 8B | LLaDA 8B | Dream 7B | Qwen2.5 7B |
|---|---|---|---|---|
| MMLU | 71.6 | 65.5 | 67.0 | 76.6 |
| MMLU-Pro | 52.3 | 37.0 | 43.3 | 56.3 |
| MMLU-Redux | 76.4 | 68.9 | 76.3 | 75.7 |
| GSM8K | 89.0 | 77.5 | 81.0 | 91.6 |
| Math | 56.7 | 42.2 | 39.2 | 75.5 |
| HumanEval | 65.9 | 49.4 | 55.5 | 84.8 |
| MBPP | 58.0 | 41.0 | 58.8 | 79.2 |
| Average | 67.1 | 54.5 | 60.2 | 77.1 |
这张表传递的信息和 Base Model 表不完全一样。
iLLaDA 相比其他 diffusion 模型仍然很强:
iLLaDA Avg = 67.1
LLaDA Avg = 54.5
Dream Avg = 60.2
但与 Qwen2.5 7B Instruct 相比:
67.1vs77.1仍有:
10.0 分的平均差距。
除了:
MMLU-Redux:76.4 > 75.7之外,大多数任务上 Qwen2.5 仍明显更强。
尤其:
Math:56.7 vs 75.5
HumanEval:65.9 vs 84.8
MBPP:58.0 vs 79.2
差距比较明显。
因此不能简单说:
iLLaDA 已经全面追平自回归 Instruct LLM更准确的表述应该是:
Base Model 层面 iLLaDA 已经非常接近甚至略超部分 AR baseline,但在指令微调后的综合能力上,与强 AR Instruct 模型仍有明显差距。
---
21. 为什么 Base 接近,但 Instruct 仍有差距
Section titled “21. 为什么 Base 接近,但 Instruct 仍有差距”仅从这份 PPT 和论文结果能直接确认的是:
Base Average:iLLaDA 63.9Qwen2.5 63.3
Instruct Average:iLLaDA 67.1Qwen2.5 77.1
也就是说:
预训练阶段的能力差距已经很小↓但 instruction tuning 后,AR baseline 的综合能力提升更明显这至少说明一个问题:
扩散语言模型的挑战已经不只在预训练,也包括如何把预训练能力更充分地转化为 instruction-following、数学、代码等下游能力。
这也是为什么论文会继续专门研究:
SFT 训练方式EOS 学习SFT epoch而不是只报告预训练结果。
---
22. SFT epoch 消融说明了什么
Section titled “22. SFT epoch 消融说明了什么”PPT 最后一页给出了:
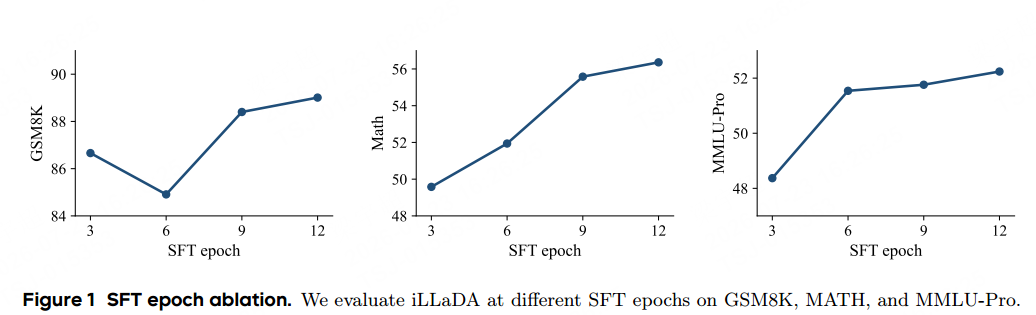
横轴是:
SFT epoch:36912评测三个任务:
GSM8KMATHMMLU-Pro整体趋势是:
训练更久↓总体继续提升其中 MATH 最明显。
大致可以看到:
MATH:
epoch 3  ≈ 49.6epoch 6  ≈ 52.0epoch 9  ≈ 55.6epoch 12 ≈ 56.3
MMLU-Pro 也是持续上升:
约 48.4↓约 51.6↓约 51.8↓约 52.3GSM8K 在 epoch 6 有一次回落,但之后继续提高:
约 86.7↓约 84.9↓约 88.4↓约 89.0所以图的核心不是:
每多一个 epoch 都严格单调上涨而是:
更长的 SFT 并没有迅速失效,多个能力指标整体仍能继续从重复训练中受益。
这也说明:
iLLaDA 的能力提升不只是靠更大的预训练 token 数量SFT 阶段本身仍有进一步优化空间。
---
23. 这篇论文最重要的几个技术连接
Section titled “23. 这篇论文最重要的几个技术连接”学习完整套方法后,我觉得最值得注意的是几个“前后环节之间的连接”。
22.1 预训练目标和 SFT 目标统一
Section titled “22.1 预训练目标和 SFT 目标统一”预训练:
随机 Mask↓恢复被 Mask tokenSFT:
完整 instruction sequence↓仍然随机 Mask↓恢复被 Mask token因此没有把模型强行切换到另一套训练范式。
22.2 SFT 和 EOS 学习连接
Section titled “22.2 SFT 和 EOS 学习连接”因为:
EOS 也是训练序列的一部分而且:
EOS 也可能被 Mask所以模型学会:
恢复 EOS22.3 EOS 学习和可变长度生成连接
Section titled “22.3 EOS 学习和可变长度生成连接”推理时:
当前 block 出现 EOS↓停止于是模型不需要固定死输出长度。
22.4 双向生成和 Confidence Scoring 连接
Section titled “22.4 双向生成和 Confidence Scoring 连接”因为模型没有天然的:
left-to-right factorization所以选择题评分也不能完全照搬传统 AR likelihood。
于是设计:
按照去噪置信度顺序揭示 token↓累加这些步骤的概率这四条关系串起来后,iLLaDA 才是一套完整系统,而不是零散技巧。
---
24. iLLaDA 的优势可以怎么总结
Section titled “24. iLLaDA 的优势可以怎么总结”23.1 双向上下文
Section titled “23.1 双向上下文”模型在恢复某个被 Mask token 时,可以利用:
左侧+右侧上下文。
23.2 块内并行
Section titled “23.2 块内并行”同一个 block 内:
多个 Mask 可以同时得到预测不是严格一次只能产生一个 token。
23.3 训练目标统一
Section titled “23.3 训练目标统一”Pre-training+SFT都使用 diffusion-style masked recovery。
23.4 可变长度生成
Section titled “23.4 可变长度生成”通过学习:
EOS模型可以在开放式生成中自行结束。
23.5 Base Model 能力强
Section titled “23.5 Base Model 能力强”在 PPT 中的 Base benchmark:
Average = 63.9已经达到非常有竞争力的水平。
---
25. iLLaDA 当前仍然有哪些明显问题
Section titled “25. iLLaDA 当前仍然有哪些明显问题”24.1 不是真正“一步并行生成全部 token”
Section titled “24.1 不是真正“一步并行生成全部 token””虽然 diffusion LM 听起来很像完全并行生成,但 iLLaDA 实际采用:
block-wise generation也就是说:
块内并行块间顺序因此它仍然具有一定顺序生成成分。
24.2 一个 block 也要多轮去噪
Section titled “24.2 一个 block 也要多轮去噪”加入一块 Mask 后:
并不是一次 forward 就全部确定而是:
高置信度 token 先固定↓低置信度 token 留到下一轮所以实际推理成本需要结合:
block size去噪轮数一起分析。
24.3 Instruct Model 仍落后强 AR baseline
Section titled “24.3 Instruct Model 仍落后强 AR baseline”最明显的是:
iLLaDA Avg = 67.1Qwen2.5 Avg = 77.1尤其数学和代码任务差距较大。
24.4 选择题评分需要专门设计
Section titled “24.4 选择题评分需要专门设计”AR 模型中的 likelihood 具有自然的序列分解。
iLLaDA 则需要:
Confidence Scoring作为排序代理。
这说明很多围绕 AR 模型成熟起来的:
generationevaluationscoringdecoding方法不能原样搬到 diffusion LM 上。
---
26. 这篇论文真正的贡献应该怎么评价
Section titled “26. 这篇论文真正的贡献应该怎么评价”这篇工作最容易被误解成:
提出了一个全新的语言扩散理论但从 PPT 的总结来看,更准确的定位是:
已有 masked diffusion language modeling+大规模训练 recipe+全序列 SFT+EOS learning+variable-length generation+confidence scoring也就是说,其价值更像:
把扩散语言模型从一个“可以生成文本”的研究路线,继续推进为一个更完整的大语言模型训练与评测系统。
尤其值得注意的是:
12T 预训练规模8192 contextGQAsequence packingfull-sequence SFTEOS recoveryblock-wise generationconfidence scoring这些部分合在一起,才构成 iLLaDA 的整体改进。
---
27. 我对 iLLaDA 的阶段性理解
Section titled “27. 我对 iLLaDA 的阶段性理解”完成这次学习后,我对 diffusion LM 的理解不再只是:
把很多 token Mask 掉然后一起补回来而是形成了更完整的流程:
原始文本↓随机采样 Mask 强度 t↓构造不同噪声程度的文本↓双向 Transformer 同时预测被遮挡位置↓只在 Mask 位置计算恢复损失↓通过大规模预训练学习任意位置恢复↓SFT 继续对完整 instruction sequence 做相同扩散训练↓EOS 也成为可恢复 token↓推理时追加 Mask block↓高置信度位置优先确定↓多轮去噪恢复当前 block↓检测 EOS↓没有 EOS 就追加下一 block↓最终得到可变长度回答这里最重要的几个概念区别是:
| 概念 | 我的理解 |
|---|---|
| AR generation | 从左到右预测下一个 token |
| Masked diffusion | 恢复任意被 Mask 的 token |
t | 当前样本的 Mask / 噪声强度 |
1/t | 平衡不同 Mask 强度下的损失规模 |
| Full-sequence SFT | Prompt / Response / EOS 都可能进入扩散训练 |
| EOS learning | 让模型学会何时结束 |
| Block-wise generation | 块内并行、块间顺序 |
| Confidence Scoring | 按最有把握的去噪顺序给候选答案排序 |
---
28. 这篇论文对“扩散 LLM 能否替代 AR”的回答是什么
Section titled “28. 这篇论文对“扩散 LLM 能否替代 AR”的回答是什么”如果只根据这份实验结果,可以给出一个比较谨慎的回答。
Base Model 层面
Section titled “Base Model 层面”答案接近:
已经非常有竞争力因为:
iLLaDA Average = 63.9Qwen2.5 Average = 63.3Instruct Model 层面
Section titled “Instruct Model 层面”答案仍然是:
还没有全面追平因为:
iLLaDA Average = 67.1Qwen2.5 Average = 77.1所以更准确的理解不是:
扩散 LM 已经替代 AR而是:
完全双向的 diffusion-style language modeling 已经能学习出很强的基础语言能力,但如何把这种能力进一步转化为强 instruction-following、数学和代码能力,仍然是重要问题。
---
29. 总结
Section titled “29. 总结”整篇论文可以压缩成下面这条主线:
自回归:预测下一个 token
iLLaDA:恢复任意被 Mask token↓随机采样不同 Mask 强度↓双向 Transformer 学习多噪声状态恢复↓12T tokens 大规模预训练↓8192 context + GQA + packing 等训练配方↓全 instruction sequence SFT↓Prompt / Response / EOS 都可能被 Mask↓模型学会恢复 EOS↓开放式 block-wise 可变长度生成↓选择题使用 Confidence Scoring↓Base Model 已非常接近强 AR baseline↓Instruct Model 仍有明显差距
我目前最核心的理解是:
iLLaDA 真正重要的地方,不只是证明“语言模型可以不用严格从左到右训练”,而是展示了如何围绕双向扩散目标重新设计预训练、SFT、停止机制、开放式生成和候选答案评分。
它最值得关注的结果是:
Base Model Average:63.9已经非常有竞争力。
它最明显的现实差距则是:
Instruct Average:67.1 vs Qwen2.5 77.1说明 diffusion LM 的下一步不只是继续扩大预训练,还要继续研究:
更高效的 decoding更强的 instruction tuning更合适的 diffusion-native evaluation以及数学 / 代码等复杂能力的训练方法---
30. 一句话记住 iLLaDA
Section titled “30. 一句话记住 iLLaDA”iLLaDA = 用双向 Mask 恢复代替“预测下一个 token”,再把这套扩散目标一路延伸到 SFT、EOS 学习、可变长度生成和 Confidence Scoring。---
31. 参考
Section titled “31. 参考”Nie et al.Improved Large Language Diffusion ModelsarXiv:2606.25331v12026